Kafka如何保证消息的顺序性
Kafka如何保证消息的顺序性
核心原理
Kafka中消息顺序性依赖于其分区(Partition)内顺序性。
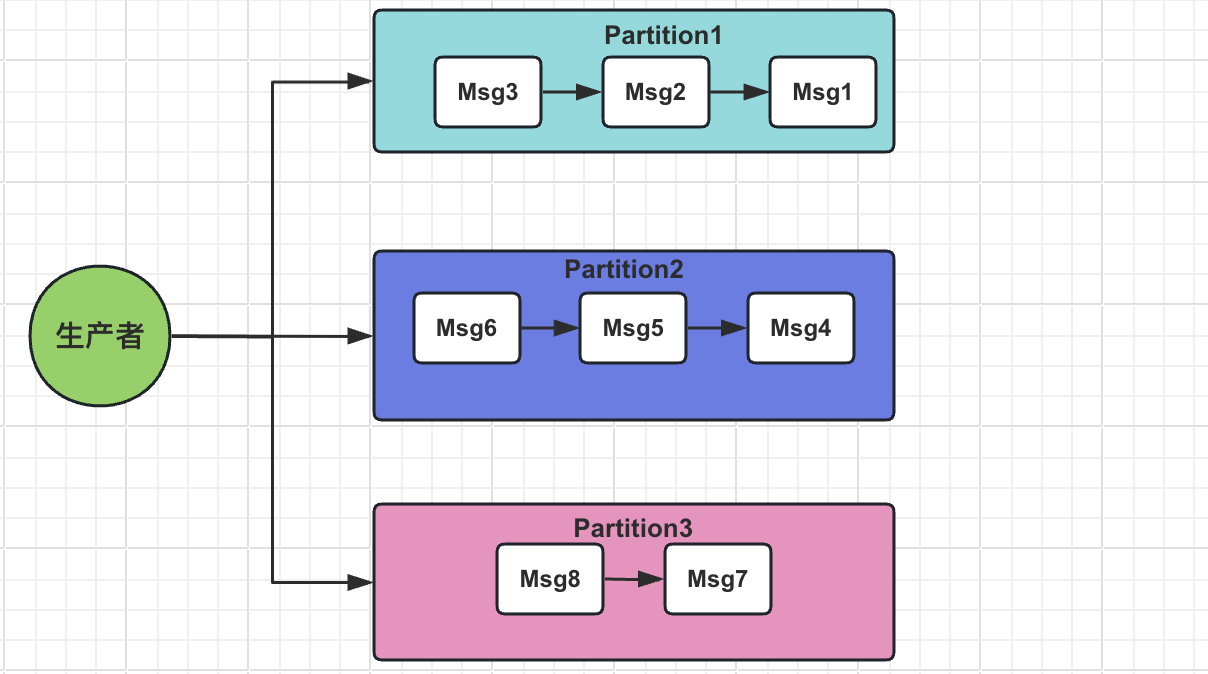
每个分区的消息都是按照先后顺序排列的,如上图一样。
在单个Kafka分区中,消息的顺序性得到了严格的保证。新产生的消息总是附加到分区日志的末端,消费者按照消息在分区中的物理顺序进行消费。如下图所示,每个分区内部的消息具有明确的偏移量(Offset),消费者按照递增的Offset顺序消费消息。
配置项
生产者yml
producer:
  bootstrap.servers: "localhost:9092"
  key.serializer: "org.apache.kafka.common.serialization.StringSerializer"
  value.serializer: "org.apache.kafka.common.serialization.StringSerializer"
  # 确保消息按顺序发送
  max.in.flight.requests.per.connection: 1
  enable.idempotence: true
  # 根据需要设置重试次数和确认级别
  retries: 3
  acks: "all"
  # 如果需要自定义分区器
  # partitioner.class: "com.example.kafka.CustomPartitioner"
解释一下对应参数的意义
消息键(Key)设置
- 作用:确保需要顺序发送的消息被路由到同一个分区。
- 配置:在发送消息时,设置相同的
key值。
分区器(Partitioner)设置
- 作用:确保根据消息的
key进行分区。 - 配置:使用默认分区器,或自定义分区器,确保相同的
key被路由到同一分区。
发送顺序性配置
配置项max.in.flight.requests.per.connection=1
作用:确保在发生重试时,消息的发送顺序不被打乱。
配置项retries
作用:根据需要设置重试次数级别
设置 acks=all 的作用是 确保消息被所有同步副本成功写入后,生产者才会收到确认,从而提供最高级别的数据可靠性。
acks 参数的取值及含义:
acks=0:
- 含义:生产者发送消息后,不等待任何确认即认为发送成功。
- 优点:吞吐量高,延迟低。
- 缺点:可能导致消息丢失,因为生产者无法确定消息是否被 Kafka 集群接收。acks=1:
- 含义:生产者在收到 首领副本(Leader) 的确认后,即认为消息发送成功,不等待副本(Follower)的确认。
- 优点:在性能和可靠性之间取得平衡。
- 缺点:如果首领副本在消息写入后但在同步到副本前发生故障,可能导致消息丢失。acks=all或acks=-1:
- 含义:生产者在收到 首领副本和所有同步副本 的确认后,才认为消息发送成功。
- 优点:提供最高级别的可靠性,确保即使首领副本故障,消息也不会丢失。
- 缺点:增加了消息发送的延迟,因为需要等待所有同步副本的确认;如果副本同步速度慢,可能影响整体性能。
幂等性
配置项enable.idempotence=true
作用:开启生产者的幂等性,防止因为重试导致的消息重复,从而影响顺序性。
消费者yml
consumer:
  bootstrap.servers: "localhost:9092"
  key.deserializer: "org.apache.kafka.common.serialization.StringDeserializer"
  value.deserializer: "org.apache.kafka.common.serialization.StringDeserializer"
  group.id: "your-consumer-group"
  # 关闭自动提交,手动控制偏移量提交
  enable.auto.commit: false
  # 控制每次拉取的最大记录数,便于顺序处理
  max.poll.records: 500
  # 如果需要从最早的偏移量开始消费
  auto.offset.reset: "earliest"
解释一下含义
为什么关闭自动偏移量提交?
自动提交可能会在消息尚未处理完毕时提交偏移量,导致消费状态与处理状态不一致。
// Java 示例
while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
    for (ConsumerRecord<String, String> record : records) {
        // 处理消息
        process(record);
    }
    // 手动提交偏移量
    consumer.commitSync();
}
如何提高效率
如果只要实现顺序性就可以,消息量比较小到这里就可以,只需要设置一个partition,然后顺序消费就可以了。但是实际业务中应该采用更高效一点的方式。只要保证key相同的分配到同一个partition就可以保证,对应业务的顺序性。
生产者
默认的方式
比如A订单和B订单都使用同一个topic,但是A和B订单内的消息需要各自保证顺序性,但是它们之间的顺序性不重要。
如果您在生产者发送消息时指定了相同的 key,Kafka 默认会将这些消息路由到同一个分区。
特殊的分区器
如果你有特殊的分区要求,也可以自定义实现分区器。
# 如果需要自定义分区器
# partitioner.class: "com.example.kafka.CustomPartitioner"
实现自定义分区器
public class KeyBasedPartitioner implements Partitioner {

    private AtomicInteger counter = new AtomicInteger(0); // 示例中使用一个原子整数作为轮询计数器

    @Override
    public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {
        List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);
        int numPartitions = partitions.size();

        // 假设key是String类型,可以根据业务需求转换key类型并计算分区索引
        if (key instanceof String) {
            int partition = Math.abs(key.hashCode() % numPartitions); // 简单的哈希取模分区策略
            // 或者实现更复杂的逻辑,比如根据key的某些特性路由到固定分区
            return partition;
        } else {
            // 如果没有key,或者key不是预期类型,可以采用默认的轮询方式
            return counter.getAndIncrement() % numPartitions;
        }
    }

    @Override
    public void close() {}

    @Override
    public void configure(Map<String, ?> configs) {}
}
消费者
最安全的情况是一次只消费一条,不会打乱生产的顺序。但是这样的效率也是比较低的。
我们可以使用线程池的方式,相同的key,顺序执行,不同的key,并发处理。
解决方案
为了在多线程环境下既保证相同键的消息按顺序处理,又提高处理效率,我们可以采用基于键的顺序执行机制。
具体来说:
- 使用全局线程池处理消息:避免为每个键创建单独的线程,防止线程数量过多。
- 为每个键维护一个消息队列:相同键的消息放入同一个队列,确保按顺序处理。
- 使用工作线程对消息进行调度:工作线程从全局队列中取出消息,按照键获取对应的消息队列进行处理。
示例代码
import java.util.concurrent.*;
import java.util.*;

public class OrderedMessageProcessor {

    // 全局消息队列,消费者将消息放入此队列
    private final BlockingQueue<ConsumerRecord<String, OrderMsg>> globalQueue = new LinkedBlockingQueue<>();

    // 键到消息队列的映射,确保相同键的消息按顺序处理
    private final ConcurrentHashMap<String, LinkedBlockingQueue<OrderMsg>> keyMessageQueues = new ConcurrentHashMap<>();

    // 线程池,工作线程从全局队列中取消息处理
    private final ExecutorService workerPool;

    public OrderedMessageProcessor(int workerThreadCount) {
        // 初始化线程池
        workerPool = Executors.newFixedThreadPool(workerThreadCount);

        // 启动工作线程
        for (int i = 0; i < workerThreadCount; i++) {
            workerPool.submit(this::processMessages);
        }
    }

    // 消费者调用此方法,将消息放入全局队列
    public void submitMessage(ConsumerRecord<String, OrderMsg> record) {
        globalQueue.offer(record);
    }

    // 工作线程从全局队列中取消息进行处理
    private void processMessages() {
        while (true) {
            try {
                ConsumerRecord<String, OrderMsg> record = globalQueue.take();
                String key = record.key();
                OrderMsg message = record.value();

                // 获取键对应的消息队列
                LinkedBlockingQueue<OrderMsg> keyQueue = keyMessageQueues.computeIfAbsent(key, k -> new LinkedBlockingQueue<>());

                // 将消息放入键对应的队列
                keyQueue.offer(message);

                // 对于每个键,使用单线程执行器保证顺序
                synchronized (keyQueue) {
                    OrderMsg msg;
                    while ((msg = keyQueue.poll()) != null) {
                        // 处理消息
                        handleMessage(msg);
                    }
                }

            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                // 处理异常,记录日志等
                break;
            }
        }
    }

    // 实际的消息处理逻辑
    private void handleMessage(OrderMsg message) {
        // 处理消息的具体逻辑
        System.out.println("Processing message for key: " + message.getOrderId());
        // 示例:模拟处理耗时
        try {
            Thread.sleep(100); // 模拟耗时操作
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    }

    // 关闭线程池
    public void shutdown() {
        workerPool.shutdown();
        try {
            if (!workerPool.awaitTermination(60, TimeUnit.SECONDS)) {
                workerPool.shutdownNow();
            }
        } catch (InterruptedException ex) {
            workerPool.shutdownNow();
            Thread.currentThread().interrupt();
        }
    }
}
public class KafkaConsumerExample {

    private final OrderedMessageProcessor messageProcessor;

    public KafkaConsumerExample() {
        // 初始化消息处理器,指定工作线程数量
        messageProcessor = new OrderedMessageProcessor(10);
    }

    public void consumeMessages() {
        // 初始化Kafka消费者
        Properties props = new Properties();
        // ... 设置消费者属性
        KafkaConsumer<String, OrderMsg> consumer = new KafkaConsumer<>(props);
        consumer.subscribe(Collections.singletonList("your-topic"));

        try {
            while (true) {
                ConsumerRecords<String, OrderMsg> records = consumer.poll(Duration.ofMillis(100));
                for (ConsumerRecord<String, OrderMsg> record : records) {
                    // 将消息提交给消息处理器
                    messageProcessor.submitMessage(record);
                }
                consumer.commitAsync();
            }
        } finally {
            consumer.close();
            messageProcessor.shutdown();
        }
    }
}
提升空间
当然这个处理方案还是有提升的空间的,比如,采用线程池,如果消息太多,可能会导致阻塞。如果key太多,会导致启用的线程过多。同时过多的线程,占用消费者服务的资源。
所以有几个改进点
- 可以使用Disruptor环形无锁队列,代替阻塞队列
- 可以把几个不同的key,映射到一个分区中